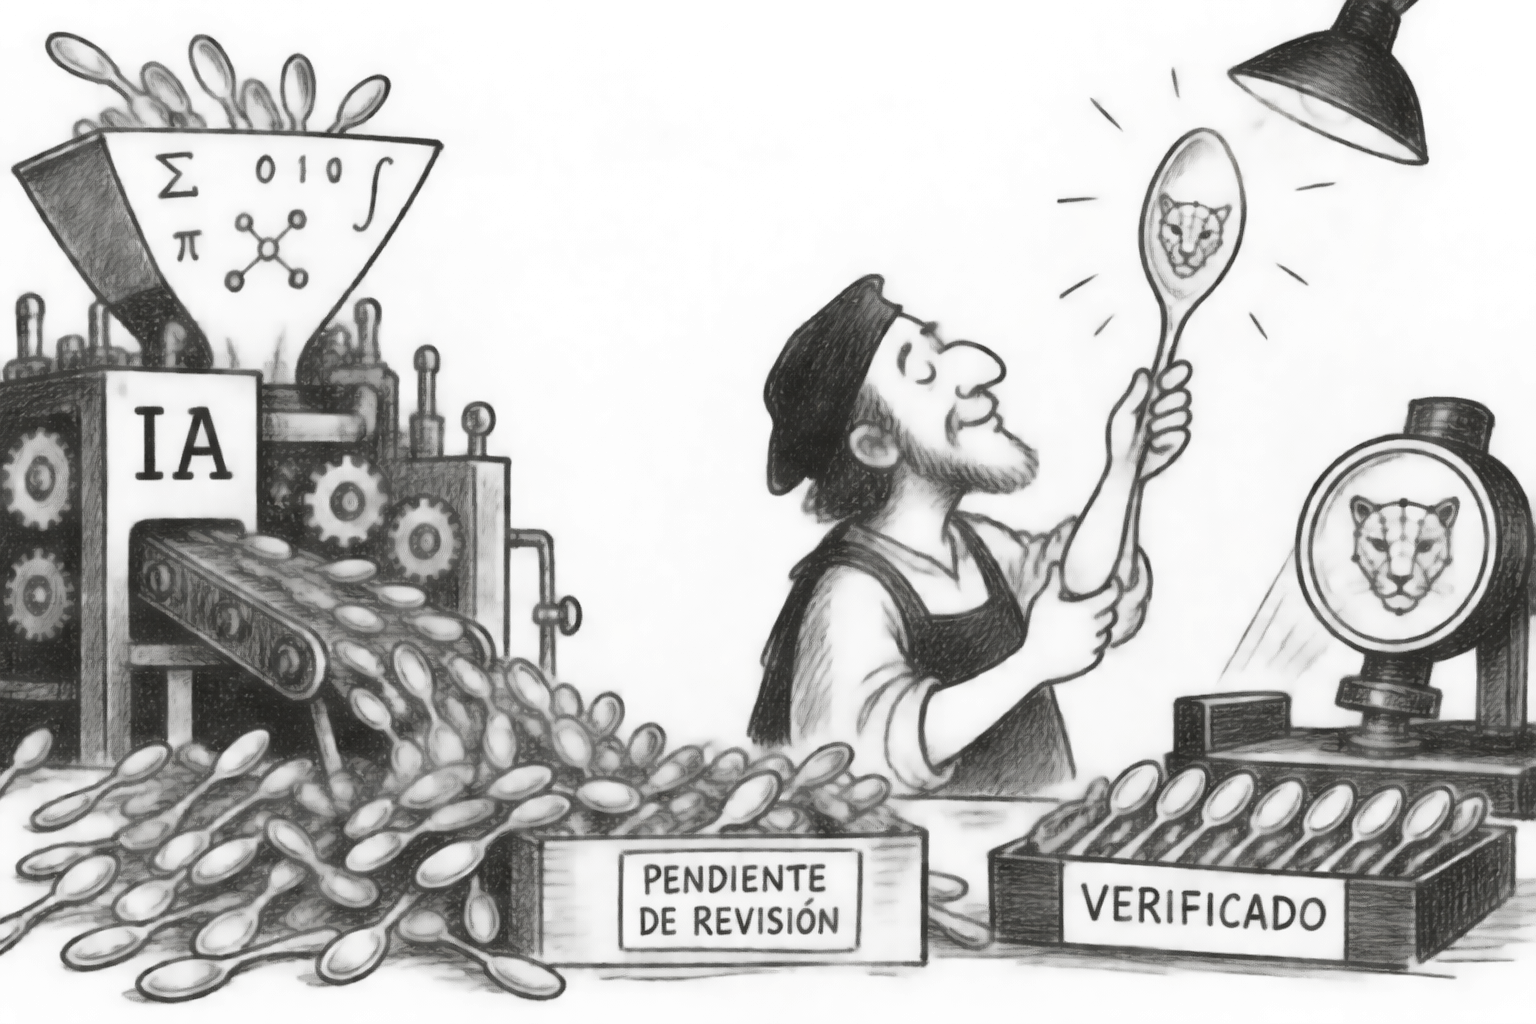
Hace unos años, en una tienda de antigüedades, vi a un hombre coger una cucharilla de plata y darle la vuelta. No miraba la cucharilla. Acercó el mango a la luz de la ventana y se quedó un rato largo con la vista clavada en cuatro marcas minúsculas estampadas en el metal, más pequeñas que la cabeza de un alfiler. Después la devolvió a su sitio, sin decir nada, y siguió con lo suyo.
Entonces me pareció un gesto de maniático. Ayer entendí que es el gesto que va a definir esta década.
La noticia no es la que ha titulado todo el mundo
El viernes 20 de noviembre, Levent Alpöge, matemático de Anthropic, publicó lo que afirma ser una demostración de la hipótesis de Riemann, el problema que Bernhard Riemann dejó planteado en 1859 y que lleva siglo y medio resistiéndose. No la publicó como un artículo. La publicó como una biblioteca de código: diecisiete millones de líneas escritas en Lean, un lenguaje pensado para escribir demostraciones de modo que una máquina pueda comprobarlas paso a paso. Cuenta que la encontró trabajando con Claude durante meses y que, cerca del final, el modelo le había adelantado.
Titulares a cascoporro. Y casi todos sobre lo mismo: la IA ha resuelto Riemann.
Pero la noticia de ayer era otra. El sábado 21, a las 13:55, las comunidades de Lean y Mathlib publicaron una declaración conjunta, respaldada por la Lean FRO y la Mathlib Initiative, con una frase que no se lee muchas veces: «Tenemos plena confianza en que la demostración de Alpöge de la hipótesis de Riemann es correcta». En un día. Y no por fe: el enunciado demostrado es el que ya estaba en Mathlib, revisado por expertos mucho antes de todo esto; decenas de personas compilaron el código por su cuenta y obtuvieron el mismo archivo exportado; dos herramientas independientes comprobaron que lo demostrado es exactamente ese enunciado y no un primo suyo; y varios núcleos de verificación distintos, escritos en lenguajes distintos, validaron la exportación, dos de ellos con una demostración formal de que no pueden aceptar una demostración falsa. El registro técnico de Andrew Sutherland, del MIT, lo recoge todo con la hora.
Nadie construyó ese aparato para esto.
El ensayador no tiene que ser mejor orfebre
En 1300, un estatuto de Eduardo I ordenó que los guardianes del oficio fueran taller por taller ensayando la plata y estampando en las piezas que daban la ley una cabeza de leopardo. Ninguna pieza podía salir de las manos del artesano sin esa marca. El Assay Office de Sheffield lo describe hoy como «una de las formas más antiguas de protección al consumidor que existen», y su objetivo original tenía dos caras: proteger al público del fraude y al buen artesano de la competencia sucia.
Fíjate en lo que no hacía el ensayador. No fabricaba la cucharilla. No tenía por qué saber hacerla mejor que el orfebre. Su trabajo era otro: tener un método, aplicado igual a todos, que separase la plata de ley de la que no lo era. Seiscientos años después, ese sigue siendo el oficio más subestimado del mundo, y ayer fue el que dio la noticia.
Conviene recordar cuánto cuesta montarlo. En agosto de 1998, Thomas Hales anunció que había demostrado la conjetura de Kepler sobre el apilamiento de esferas: doscientas cincuenta páginas de notas y tres gigabytes de programas y datos. Los Annals of Mathematics pusieron a doce revisores. En 2003, tras cuatro años de trabajo, el jefe del panel, Gábor Fejes Tóth, informó de que estaban «99 % seguros» de que la demostración era correcta, pero que no podían certificar todos los cálculos del ordenador.
Un noventa y nueve por ciento es un suspenso en matemáticas.
Hales no se resignó a ese uno por ciento: ese mismo año lanzó el proyecto Flyspeck para formalizar su demostración entera y que la comprobase una máquina. Calculó veinte años de trabajo. Tardó once: la verificación se completó el 10 de agosto de 2014, con veintiún colaboradores. Once años para poner el punzón a una sola demostración. Ayer, el punzón estaba puesto en veinticuatro horas, porque mientras nadie miraba había gente construyendo la oficina de contraste.
Lo que pasó ocho horas después
Y aquí viene la parte más honesta del fin de semana. El mismo viernes, Ravi Vakil, profesor de Stanford y presidente de la American Mathematical Society, publicó a toda prisa el borrador de otra demostración, esta de Alessandro Masullo, y subrayó un detalle: «Es todo humano, sin IA». Unas ocho horas más tarde actualizó la entrada. Varias personas le habían señalado problemas en la demostración —algunos detectados con ayuda de modelos de IA— y añadió una frase que deberíamos enmarcar: «No hago ninguna afirmación sobre la corrección de la estrategia de la demostración».
Dos borradores, un fin de semana. Uno hecho con IA y comprobado por una máquina en un día. Otro hecho solo por humanos y agujereado en ocho horas. Lo que separa a uno del otro no es quién lo escribió.
Es que a uno se le podía poner el punzón.
Los asteriscos, que nunca faltan
Lo que certificaron ayer es el objeto formal, no la comprensión. La propia declaración lo dice entre líneas al despedirse: esperan la actividad de la comunidad matemática «que ayude a explicar las nuevas ideas de esta demostración». O sea: sabemos que es verdad y todavía no sabemos bien por qué. Alpöge reconoce que presenta un resultado cuyo contexto matemático no domina del todo y promete una versión legible en los próximos meses. Sutherland anota que buena parte de las compilaciones se hicieron en máquinas en la nube sin aislamiento y que faltaban comprobaciones por cerrar. Y hay algo más grande: las matemáticas son la única parcela del conocimiento humano donde esto se puede hacer así. En medicina, en derecho o en una empresa no existe un núcleo que te diga «esto es correcto» y se calle. No traslades la buena noticia tal cual.
¿Y tu punzón?
Te propongo el ejercicio, que no es matemático. Piensa en tu equipo o en tu departamento y responde a una pregunta sola: ¿quién pone aquí la marca del leopardo? No quién produce. Quién certifica, con qué método y aplicándoselo a todos igual.
Permíteme un dato incómodo. El informe State of AI in Quality Engineering 2026, publicado el 16 de noviembre por TestMu AI, dice que el 81 % de los equipos de software han integrado código o tests generados por IA que no entendían del todo, y que la mitad gasta la mayor parte de su presupuesto en generar salida frente a un 17 % que lo gasta en verificarla. Con el asterisco de rigor: es una encuesta autodeclarada, publicada por una empresa que vende precisamente herramientas de testing, y en lo que he podido leer no figura ni la metodología ni el tamaño de la muestra. Tómalo como un síntoma, no como una medición.
Pero el síntoma encaja con lo que veo en cada conversación: hemos metido una capacidad de producción enorme en organizaciones que no han tocado su capacidad de comprobación. Y la buena noticia —la de verdad, la que trajo el sábado— es que el cuello de botella no está en la tecnología. Está en una decisión de prioridades que puedes empezar a cambiar el lunes. Ya escribí sobre lo que ocurre cuando dejamos al humano dentro del bucle como adorno y no como criterio, y sobre por qué la tabla de resultados de un modelo nuevo no es lo importante. Desde Human-IA llevamos tiempo insistiendo en lo mismo desde otro ángulo: expandir el potencial humano no va solo de producir más, va de poder responder de lo que produces. Ayer quedó claro cuál de las dos cosas da la noticia.
Volvamos a la cucharilla.
Aquel hombre no sabía hacer plata. Sabía leer un punzón, y con eso le bastaba para no tragar. Hoy tenemos sobre la mesa herramientas que fabrican plata a una velocidad que no habíamos visto nunca, y eso es extraordinario: el que se queje de que la demostración vino de una máquina se está mirando el dedo. Pero toda esa plata vale lo que valga tu capacidad de darle la vuelta y mirar el mango.
Así que la pregunta es si estás construyendo tu oficina de contraste o esperando que alguien te la preste.
#hipótesis-de-Riemann #verificación-formal #Lean-y-Mathlib #IA-y-matemáticas #calidad-del-software #potencial-humano